IA privée et conformité
Une commande ne nécessite aucune autorisation. Pas besoin de ticket ni de demander l’avis du service informatique. Un onglet de navigateur et quelques minutes suffisent. C’est précisément ce qui rend l’IA si utile en entreprise et ce qui rend son contrôle si complexe. La question n’est donc plus de savoir si ChatGPT, Microsoft Copilot, Gemini ou Claude sont utilisés au quotidien. Ce qui importe, c’est de savoir quelles données parviennent à quel outil et ce qu’il en fait.
La responsabilité incombe à l'entreprise
Que les collaborateurs révisent un texte, résument un contrat ou analysent des données clients : la responsabilité des données traitées incombe à l'entreprise. La loi suisse sur la protection des données ne fait d'ailleurs aucune distinction entre les applications classiques et l'IA. Quiconque traite des données à caractère personnel doit notamment garantir la transparence, la limitation de la finalité et la proportionnalité. En cas de traitements à haut risque, une analyse d’impact relative à la protection des données peut en outre s’avérer nécessaire.
La synthèse régulièrement mise à jour du cabinet VISCHER et de l’avocat David Rosenthal fournit des repères pour le choix de services d’IA adaptés. Elle ne se contente pas d’examiner ChatGPT, Copilot ou Gemini dans leur ensemble, mais distingue les différentes variantes concrètes de produits et de contrats.
Avant d’autoriser l’utilisation d’un service d’IA, les entreprises devraient donc se poser certaines questions fondamentales :
- Des données à caractère personnel ou des données à caractère personnel particulièrement sensibles sont-elles traitées ?
- Les données saisies contiennent-elles des contrats, des offres, des stratégies internes ou d’autres informations confidentielles ?
- Les informations sont-elles soumises au secret professionnel ou au secret de fonction ?
- Existe-t-il un contrat de sous-traitance approprié ou un accord de traitement des données ?
- Le prestataire utilise-t-il les données saisies à des fins d’apprentissage automatique, d’amélioration du service ou à d’autres fins propres ?
- Les données sont-elles stockées à des fins de détection des abus ou de surveillance des abus ?
- Des services supplémentaires tels que la recherche sur le Web ou le « grounding » sont-ils activés ?
Le fait de corriger un texte marketing général ou de mettre en ligne un contrat client fait une différence cruciale. C’est précisément cette dernière question qui est souvent négligée : des services supplémentaires tels que la recherche sur le Web peuvent impliquer leurs propres flux de données et conditions contractuelles.
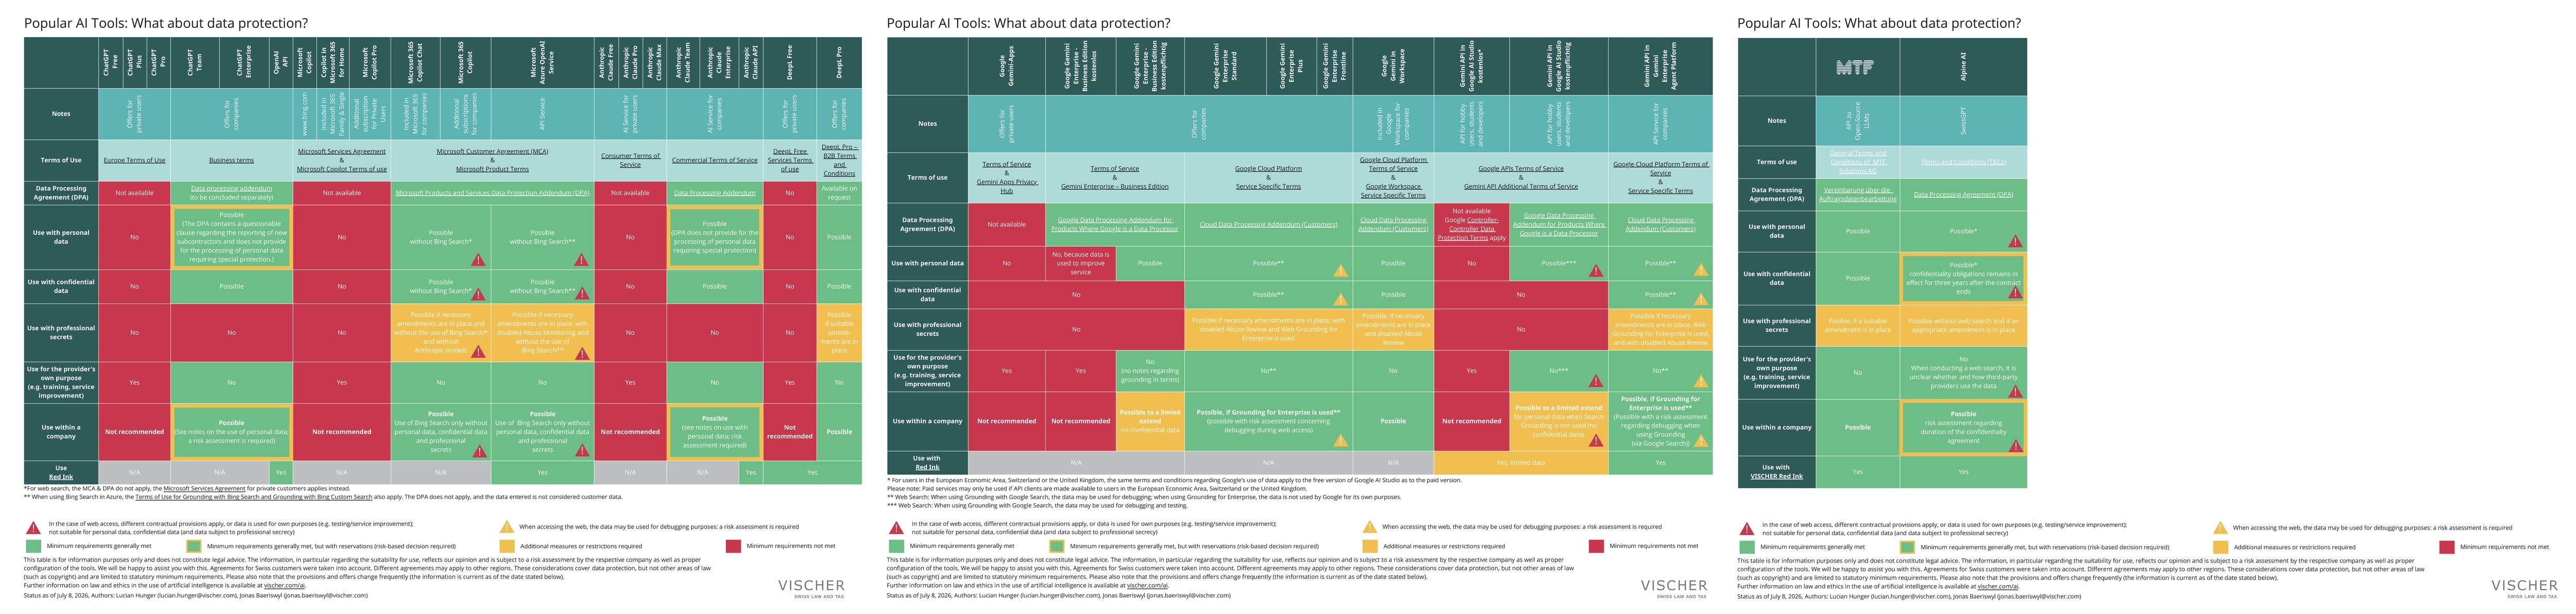
Le dossier VISCHER intitulé « Outils d'IA courants : qu'en est-il de la protection des données ? » compare les solutions d'IA couramment utilisées, notamment en ce qui concerne les données à caractère personnel, les informations confidentielles ainsi que les secrets professionnels et les secrets de fonction. Mise à jour : 8 juillet 2026.
Quelles données peuvent être transmises et où ?
Les informations publiques ne sont pas soumises aux mêmes exigences que les documents internes, les données clients ou les secrets d'affaires. Un service d'IA ne peut donc pas être qualifié de manière générale de sûr ou de dangereux. Ce qui est déterminant, c'est la nature des données traitées et les conditions dans lesquelles ce traitement a lieu.
À cet égard, le nom du fournisseur ne suffit pas à lui seul. Les versions ChatGPT Free, Plus, Business, Enterprise et l’API se distinguent par exemple en termes de contrat, de traitement des données et de fonctionnalités. Il en va de même pour les offres de Microsoft, Google ou Anthropic.
Les entreprises ne devraient donc pas se contenter d’adopter « ChatGPT » ou « Copilot » , mais une variante de produit spécifique, avec des conditions contractuelles et des paramètres bien définis.
La question cruciale n’est donc pas : « Quelle IA est sûre ? », mais : « Quelles données peuvent être traitées avec quel service spécifique ? »
Mise à la terre Web : lorsqu'un flux de données supplémentaire apparaît
Il existe un aspect que l'on a tendance à négliger lorsqu'on utilise l'IA : la recherche sur Internet, ou « web grounding ».
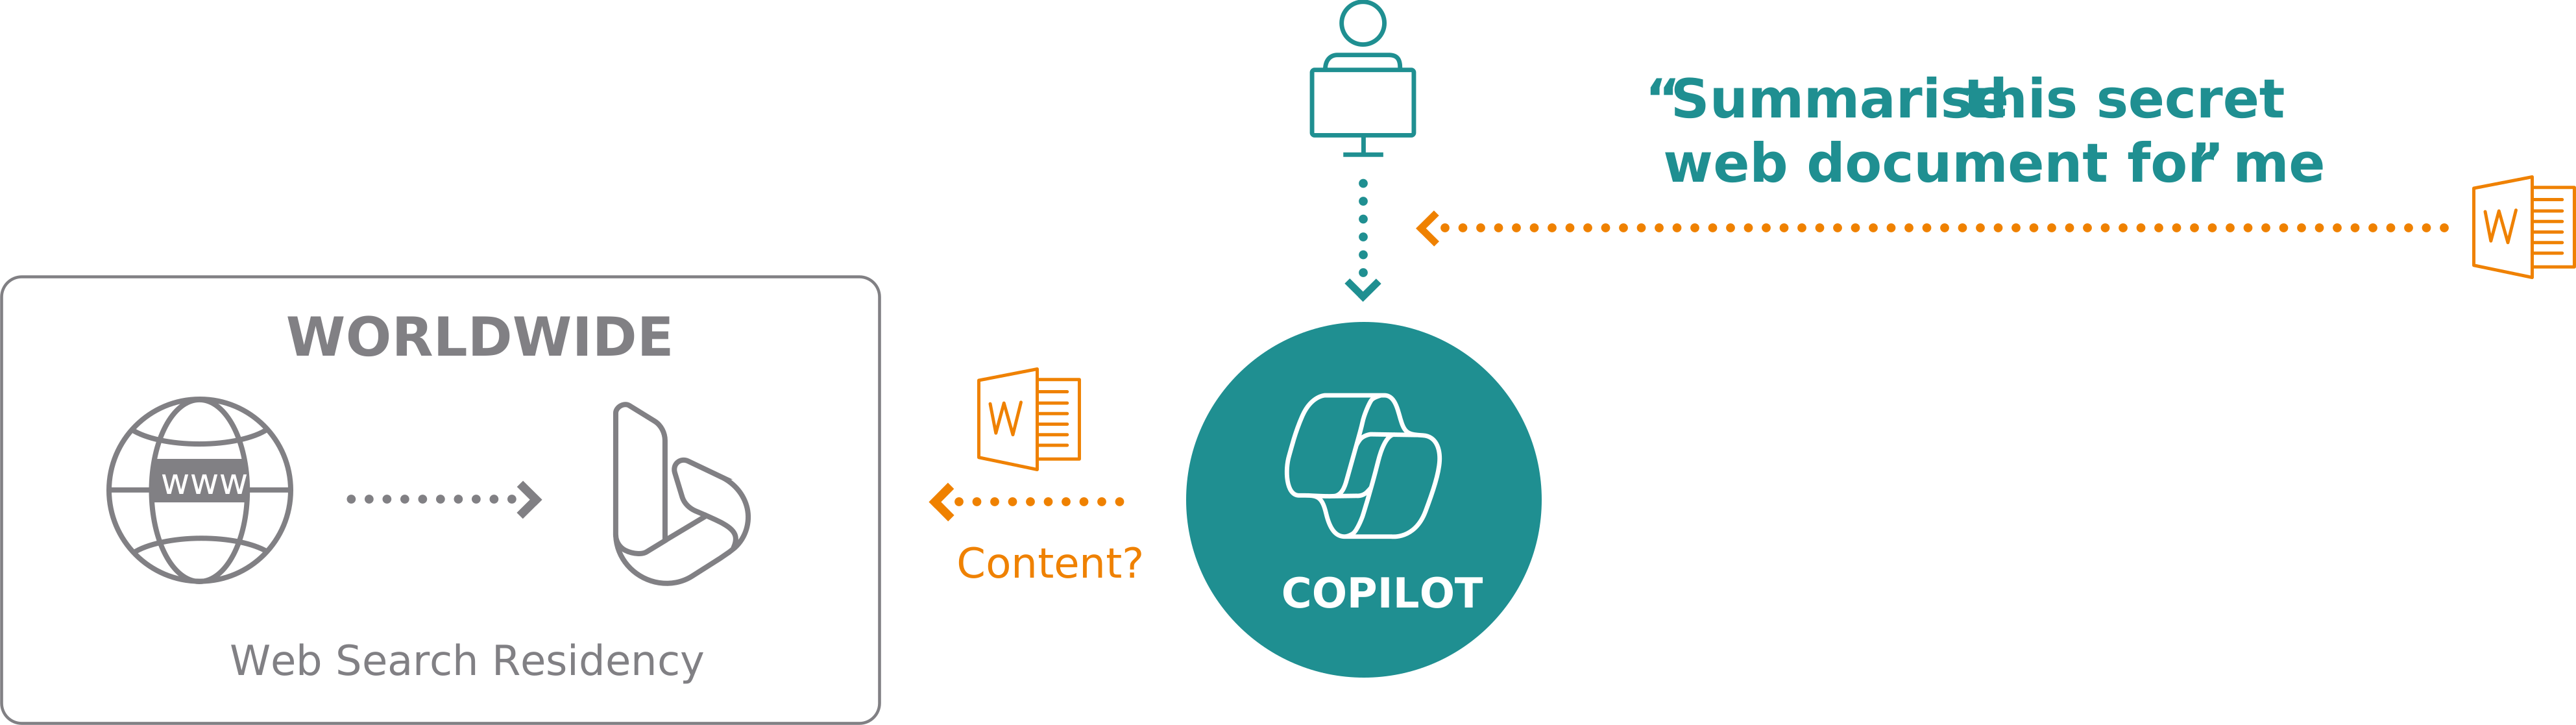
De nombreux assistants IA peuvent ainsi intégrer des informations actuelles provenant d'Internet dans leurs réponses. Dans ce cadre, certaines parties d'une requête peuvent être transmises à un moteur de recherche. Pour cette étape de traitement, les conditions contractuelles ou les lieux de stockage des données peuvent différer de ceux du service d'IA proprement dit, selon le fournisseur.
Dans le cas de Microsoft 365 Copilot, VISCHER souligne par exemple que, lorsque Bing Search est utilisé pour cette étape de traitement, la DPA de Microsoft ne s’applique pas.
Cela revêt une importance particulière lorsque la requête de recherche contient déjà des informations confidentielles. Le nom d’un client, des informations issues d’un contrat ou des détails relatifs à un projet interne peuvent faire partie d’une telle requête.
La mise en œuvre concrète varie selon le fournisseur et le produit. MTF recommande donc de ne pas activer par défaut la recherche sur le Web et le « grounding » dans les environnements d’entreprise. Ces fonctionnalités doivent être utilisées de manière ciblée, là où elles sont nécessaires pour le cas d’utilisation concerné et où les flux de données associés sont clairement définis.
Les différences résident dans les détails
Outre la recherche sur Internet, d'autres facteurs entrent en ligne de compte : l'emplacement des données, l'utilisation des données saisies à des fins d'apprentissage, la surveillance des abus, les délais de conservation, la non-conservation des données et les garanties contractuelles.
Une comparaison simplifiée basée sur l'analyse MTF met en évidence certaines de ces différences :
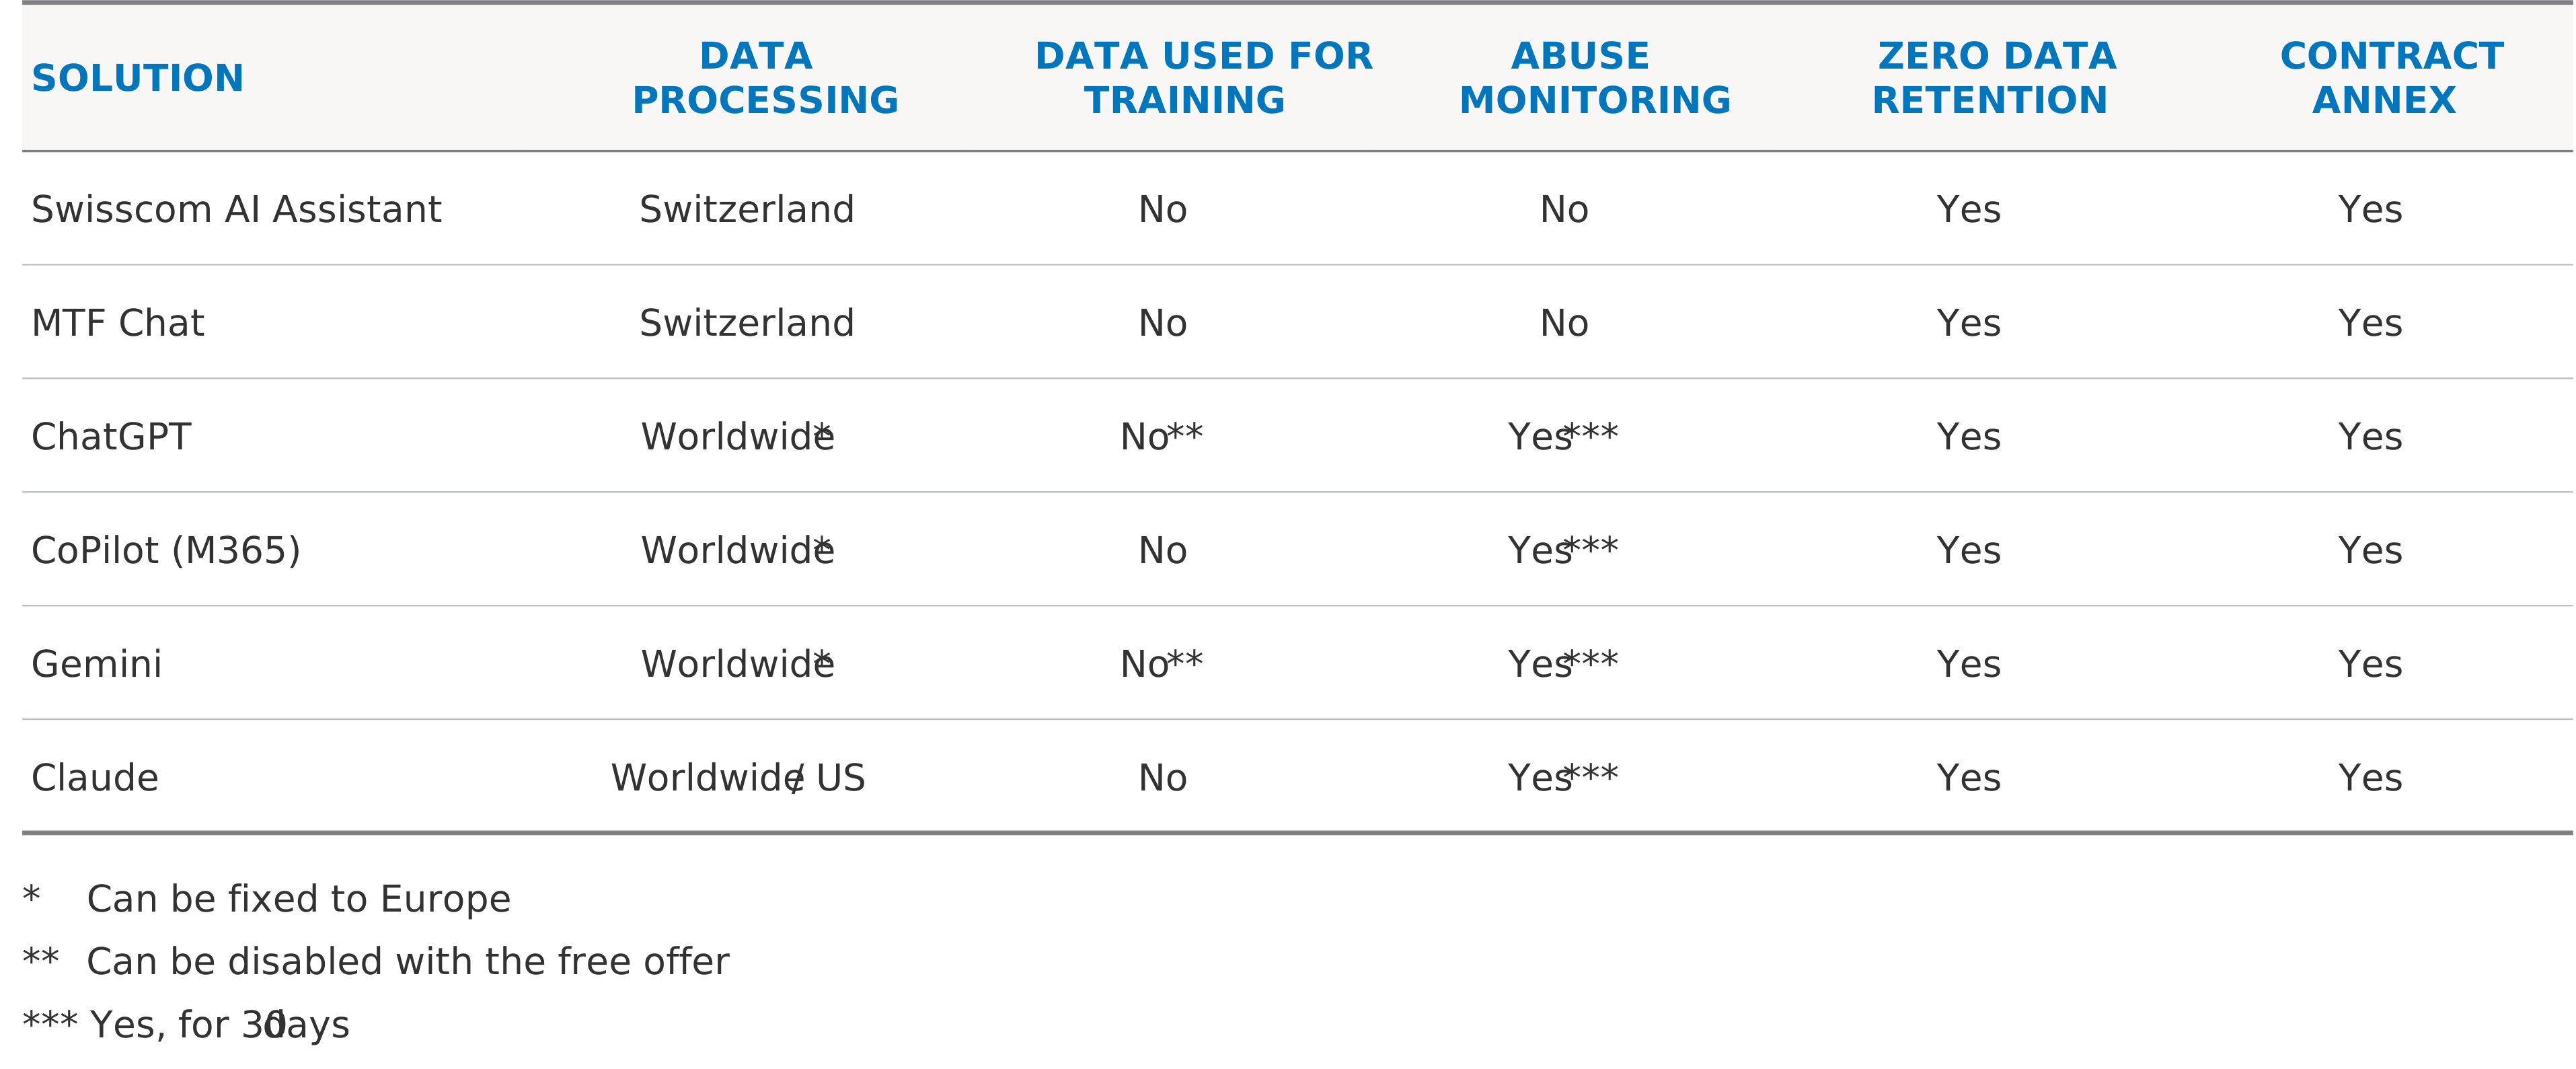
Classification simplifiée basée sur l'analyse MTF des solutions d'IA courantes. Les variantes de produits, les fonctionnalités et les conditions contractuelles varient et sont susceptibles d'évoluer. Ce sont donc toujours les conditions du service concrètement utilisé qui font foi.
Dans le cadre de certaines offres internationales, les contenus peuvent être conservés pendant une durée limitée à des fins de détection des abus. C’est pourquoi il convient de vérifier, en particulier pour les informations confidentielles ainsi que pour les secrets professionnels et les secrets de fonction, si ce traitement est compatible avec les exigences de confidentialité requises.
Outre le lieu de stockage des données, il est également important de savoir quels sous-traitants sont impliqués et à quelles juridictions sont soumis le prestataire et le traitement des données. Pour les offres « Business » et « Enterprise », la décision quant à l’adéquation d’un service au cas d’utilisation prévu repose donc non seulement sur le contrat et la configuration, mais aussi sur une évaluation documentée des risques.
Ce qui a changé en 2026 pour les fournisseurs suisses d'IA
Le dernier aperçu VISCHER de juillet 2026 inclut pour la première fois des fournisseurs suisses d'IA. MTF Solutions AG en fait partie.
VISCHER considère en principe que l’utilisation de cette solution pour les données confidentielles et les données à caractère personnel est possible, sous réserve du respect des conditions requises. MTF figure également parmi les prestataires référencés pour les secrets professionnels et les secrets de fonction, à condition que l’avenant contractuel prévu soit utilisé.
Il ne s’agit pas d’un label de qualité et cela ne remplace pas l’examen du cas d’utilisation concret. Pour les entreprises, cette classification indépendante offre toutefois une orientation supplémentaire dans le choix de solutions d’IA adaptées.
Chez MTF Private AI, ce n’est pas un modèle linguistique unique qui est au centre, mais le modèle d’exploitation. Les services d’IA fonctionnent dans le MTF Private Cloud ; l’inférence et le traitement des données s’effectuent en Suisse. Les données des clients ne sont pas utilisées pour l’entraînement des modèles. À cela s’ajoutent une conservation zéro des données et un fonctionnement sans surveillance des abus.
Les exigences sont d’autant plus strictes lorsqu’il s’agit d’informations soumises au secret professionnel ou au secret de fonction. Cela concerne par exemple les fiduciaires, les cabinets d’avocats, les administrations, les organismes de santé ou d’autres institutions publiques. La seule localisation des données ne suffit pas dans ce cas. La protection contractuelle est également déterminante. À cet effet, MTF met à disposition un avenant contractuel adapté.
Une classification simple des données apporte de la clarté
Une interdiction générale de l'IA résout rarement le problème. Si les collaborateurs ne disposent pas d’outils adaptés, le risque qu’ils utilisent des services librement accessibles en dehors des directives de l’entreprise augmente. Une gouvernance efficace de l’IA commence donc par une réponse claire à la question suivante : quelles données peuvent être traitées avec quels services ?
Une classification simple peut déjà faire toute la différence :
- Informations publiques
Peuvent être traitées dans des services d’IA publics agréés à cet effet. - Informations internes
Ne doivent être traitées qu’à l’aide de solutions « Business » ou « Enterprise » testées et validées. - Informations confidentielles ou particulièrement sensibles
Nécessitent des mesures de protection techniques et contractuelles adaptées. - Secrets professionnels et secrets de fonction
Elles nécessitent un examen spécifique et une protection contractuelle adaptée.
Il est ainsi possible d’en déduire des directives d’utilisation concrètes à l’intention des collaborateurs. Au lieu de longues listes d’interdictions, on obtient ainsi des repères simples pour le quotidien professionnel.
Conclusion : Ce sont les données qui décident
L'IA publique et l'IA privée répondent à des besoins différents. Pour de nombreuses tâches quotidiennes, les services professionnels et d'entreprise proposés par le cloud public peuvent constituer le bon choix. Plus les informations sont confidentielles et plus les exigences en matière de souveraineté des données et de confidentialité sont élevées, plus le traitement des données, le modèle d'exploitation et les garanties contractuelles prennent de l'importance.
Les entreprises ne doivent donc pas bloquer le plus grand nombre possible de services d’IA. Elles doivent plutôt savoir quels outils sont utilisés, quelles données sont traitées et quel service est autorisé pour quel cas d’utilisation.
À l’avenir, une instruction ne nécessitera toujours pas d’autorisation. Mais si l’on sait clairement quelles données peuvent aller où, elle n’en aura pas besoin non plus.
MTF : votre partenaire pour une utilisation sécurisée de l'IA
MTF aide les PME suisses à intégrer l'IA de manière contrôlée dans leur quotidien professionnel. Cela comprend le classement des données et des cas d'utilisation, la définition de directives d'utilisation claires, ainsi que la sélection et la mise en œuvre technique de solutions d'IA publiques et privées adaptées.
Il en résulte un environnement d'IA qui favorise la productivité tout en répondant aux exigences de l'entreprise en matière de protection des données, de confidentialité et de souveraineté des données.
FAQ
- Les collaborateurs sont-ils autorisés à utiliser ChatGPT, Copilot ou Gemini avec des données d'entreprise ?
Cela dépend des données traitées, ainsi que de la version du produit, du contrat et de la configuration. Les offres grand public librement accessibles sont souvent inadaptées aux données d’entreprise sensibles. Les offres « Business » et « Enterprise » peuvent être utilisées sous certaines conditions appropriées.
- Une version payante d’IA est-elle automatiquement conforme à la protection des données ?
Non. Une licence « Business » ou « Enterprise » peut offrir de meilleures conditions contractuelles, mais ne remplace pas l’évaluation de l’utilisation concrète. Les éléments déterminants sont notamment l’accord de traitement des données (DPA), le traitement des données, les délais de conservation et la configuration.
- Pourquoi la recherche sur le Web dans les outils d’IA constitue-t-elle un enjeu de conformité à part entière ?
Parce qu’une recherche sur le Web peut impliquer des services supplémentaires dans le traitement des données. Certaines parties d’une requête peuvent ainsi être soumises à des conditions contractuelles et à des flux de données différents de ceux de l’application d’IA proprement dite.
- Que signifie « zéro conservation des données » ?
La « zéro conservation des données » signifie que le contenu d’une requête n’est pas conservé par le prestataire au-delà de la durée nécessaire au traitement immédiat. Les modalités techniques et contractuelles concrètes doivent être vérifiées auprès du service concerné.
- Qu’en est-il des secrets professionnels et des secrets de fonction ?
Dans ce cas, les exigences en matière de confidentialité et de protection de l’accès sont plus strictes. Outre les mesures techniques, des dispositions contractuelles appropriées sont nécessaires. Un contrat de sous-traitance classique ne suffit pas toujours à cet effet.
- Qu’est-ce qui distingue l’IA publique de l’IA privée ?
L’IA publique est fournie via l’infrastructure d’un fournisseur de plateforme externe. Dans le cas de l’IA privée, l’environnement d’exploitation peut être spécifiquement adapté à des exigences telles que la localisation des données, leur stockage et leur confidentialité. Le choix de la variante la plus appropriée dépend du cas d’utilisation concerné et des données traitées.
- Qu’est-ce que la surveillance des abus ?
Dans le cadre de la surveillance des abus, un fournisseur vérifie les requêtes ou les résultats afin de détecter d’éventuelles violations de ses directives d’utilisation et de sécurité. Selon le service, les contenus peuvent être stockés ou analysés pendant une durée limitée à cette fin. Pour les données particulièrement confidentielles, cet aspect doit donc être vérifié avant toute utilisation.
- Comment MTF accompagne-t-il les entreprises en matière de gouvernance de l’IA ?
MTF accompagne les entreprises depuis la classification de leurs données et de leurs cas d’utilisation, en passant par l’élaboration de politiques d’utilisation, jusqu’à la sélection et la mise en œuvre de solutions d’IA publiques et privées adaptées.
Aussi intéressant
Avez-vous des Questions ?
Tobias Menzi
Geschäftsleiter Region Liechtenstein, St. Gallen & Chur