IA privata e conformità
Un prompt non richiede alcuna autorizzazione. Nessun ticket, nessuna richiesta di conferma al reparto IT. Bastano una scheda del browser e pochi minuti. È proprio questo che rende l’IA così utile in azienda e il suo controllo così impegnativo. La questione, quindi, non è più se ChatGPT, Microsoft Copilot, Gemini o Claude vengano utilizzati nella quotidianità lavorativa. Ciò che conta è quali dati raggiungono quale strumento e cosa ne viene fatto.
La responsabilità rimane a carico dell’azienda
Che i collaboratori rivedano un testo, sintetizzino un contratto o analizzino i dati dei clienti: la responsabilità per i dati trattati rimane a carico dell’azienda. Anche la legge svizzera sulla protezione dei dati non fa alcuna distinzione tra applicazioni tradizionali e IA. Chi tratta dati personali deve garantire, tra l’altro, trasparenza, limitazione delle finalità e proporzionalità. In caso di trattamenti ad alto rischio, può essere inoltre necessaria una valutazione d’impatto sulla protezione dei dati.
La panoramica costantemente aggiornata dello studio legale VISCHER e dell’avvocato David Rosenthal offre un orientamento nella scelta di servizi di IA adeguati. Essa non si limita a considerare ChatGPT, Copilot o Gemini nel loro insieme, ma distingue tra specifiche varianti di prodotto e contrattuali.
Prima di autorizzare l’utilizzo di un servizio di IA, le aziende dovrebbero quindi chiarire alcune questioni fondamentali:
- Vengono trattati dati personali o dati personali particolarmente sensibili?
- I dati inseriti contengono contratti, offerte, strategie interne o altre informazioni riservate?
- Le informazioni sono soggette al segreto professionale o d’ufficio?
- Esiste un adeguato contratto di trattamento dei dati o un Data Processing Agreement?
- Il fornitore utilizza i dati inseriti per scopi di formazione, miglioramento del servizio o altri scopi propri?
- I dati vengono memorizzati per il rilevamento degli abusi o per il monitoraggio degli abusi?
- Sono attivi servizi aggiuntivi come la ricerca web o il grounding?
Che si tratti della correzione di un testo di marketing generico o del caricamento di un contratto con un cliente, la differenza è fondamentale. Proprio l’ultima domanda viene spesso trascurata: servizi aggiuntivi come la ricerca sul web possono comportare flussi di dati e condizioni contrattuali propri.
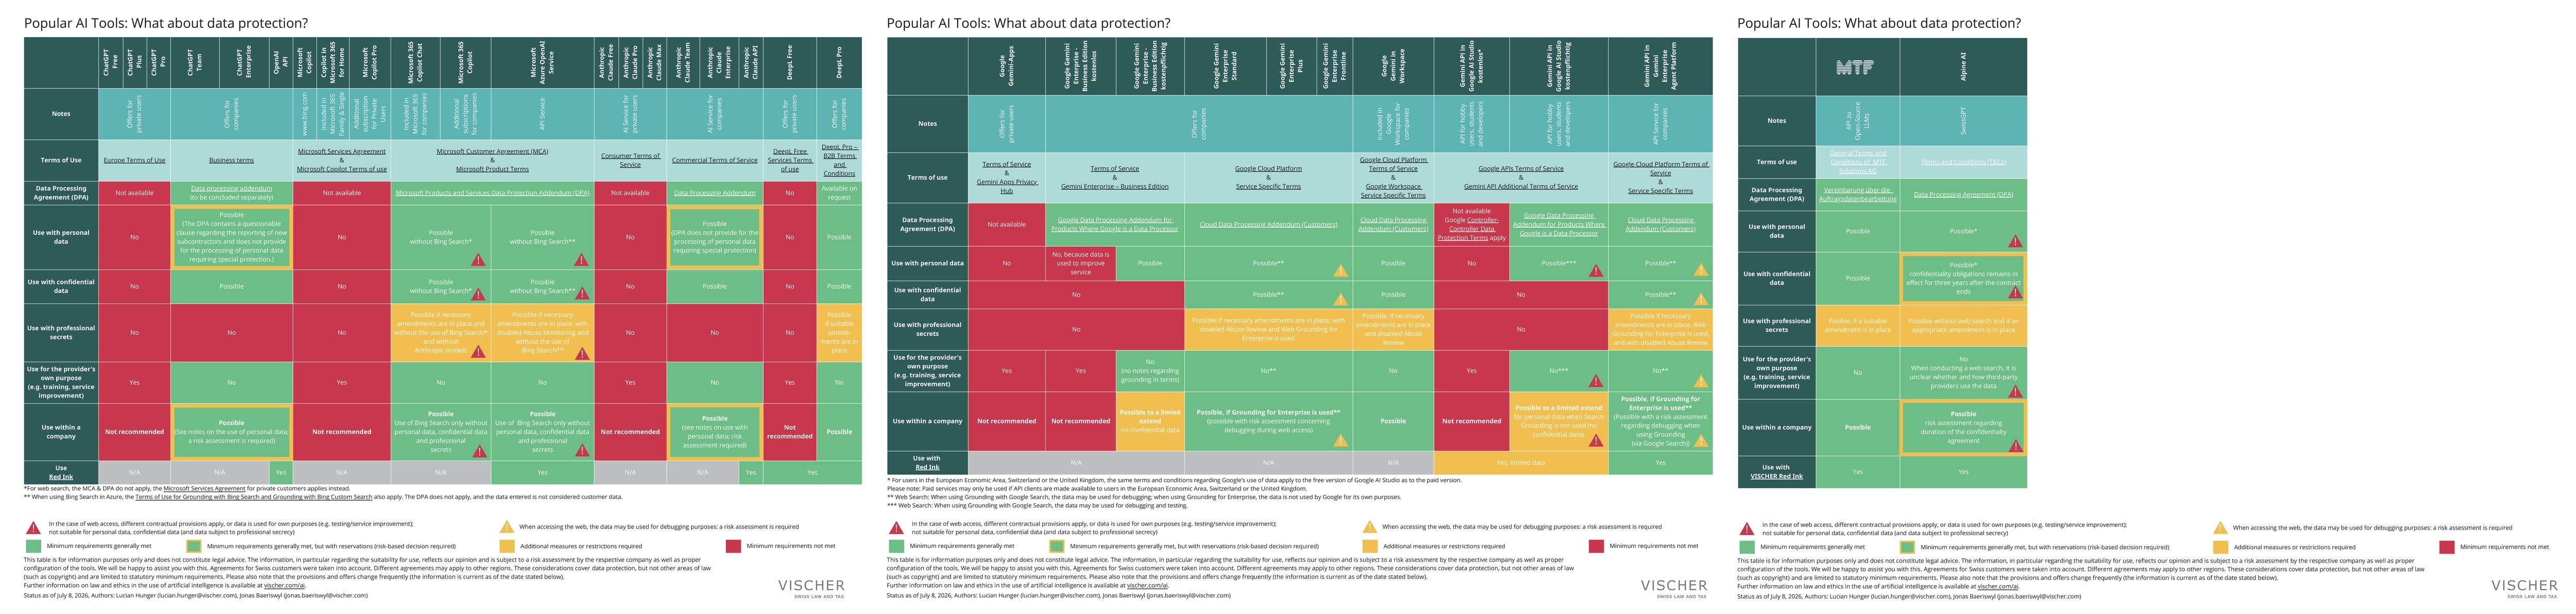
Quali dati possono essere trasmessi e dove?
Le informazioni pubbliche presentano requisiti diversi rispetto ai documenti interni, ai dati dei clienti o ai segreti commerciali. Non è quindi possibile classificare in modo generico un servizio di IA come sicuro o non sicuro. È determinante quali dati vengono trattati e a quali condizioni ciò avviene.
A tal proposito, non è sufficiente nemmeno il nome del fornitore. ChatGPT Free, Plus, Business, Enterprise e l’API, ad esempio, si differenziano per quanto riguarda il contratto, il trattamento dei dati e le funzionalità. Lo stesso vale per le offerte di Microsoft, Google o Anthropic.
Le aziende non dovrebbero quindi limitarsi a «ChatGPT» o «Copilot» , ma una variante specifica del prodotto con condizioni contrattuali e impostazioni ben definite.
La domanda fondamentale non è quindi: quale IA è sicura? Ma piuttosto: quali dati possono essere trattati con quale servizio specifico?
Web-Grounding: quando si verifica un flusso di dati aggiuntivo
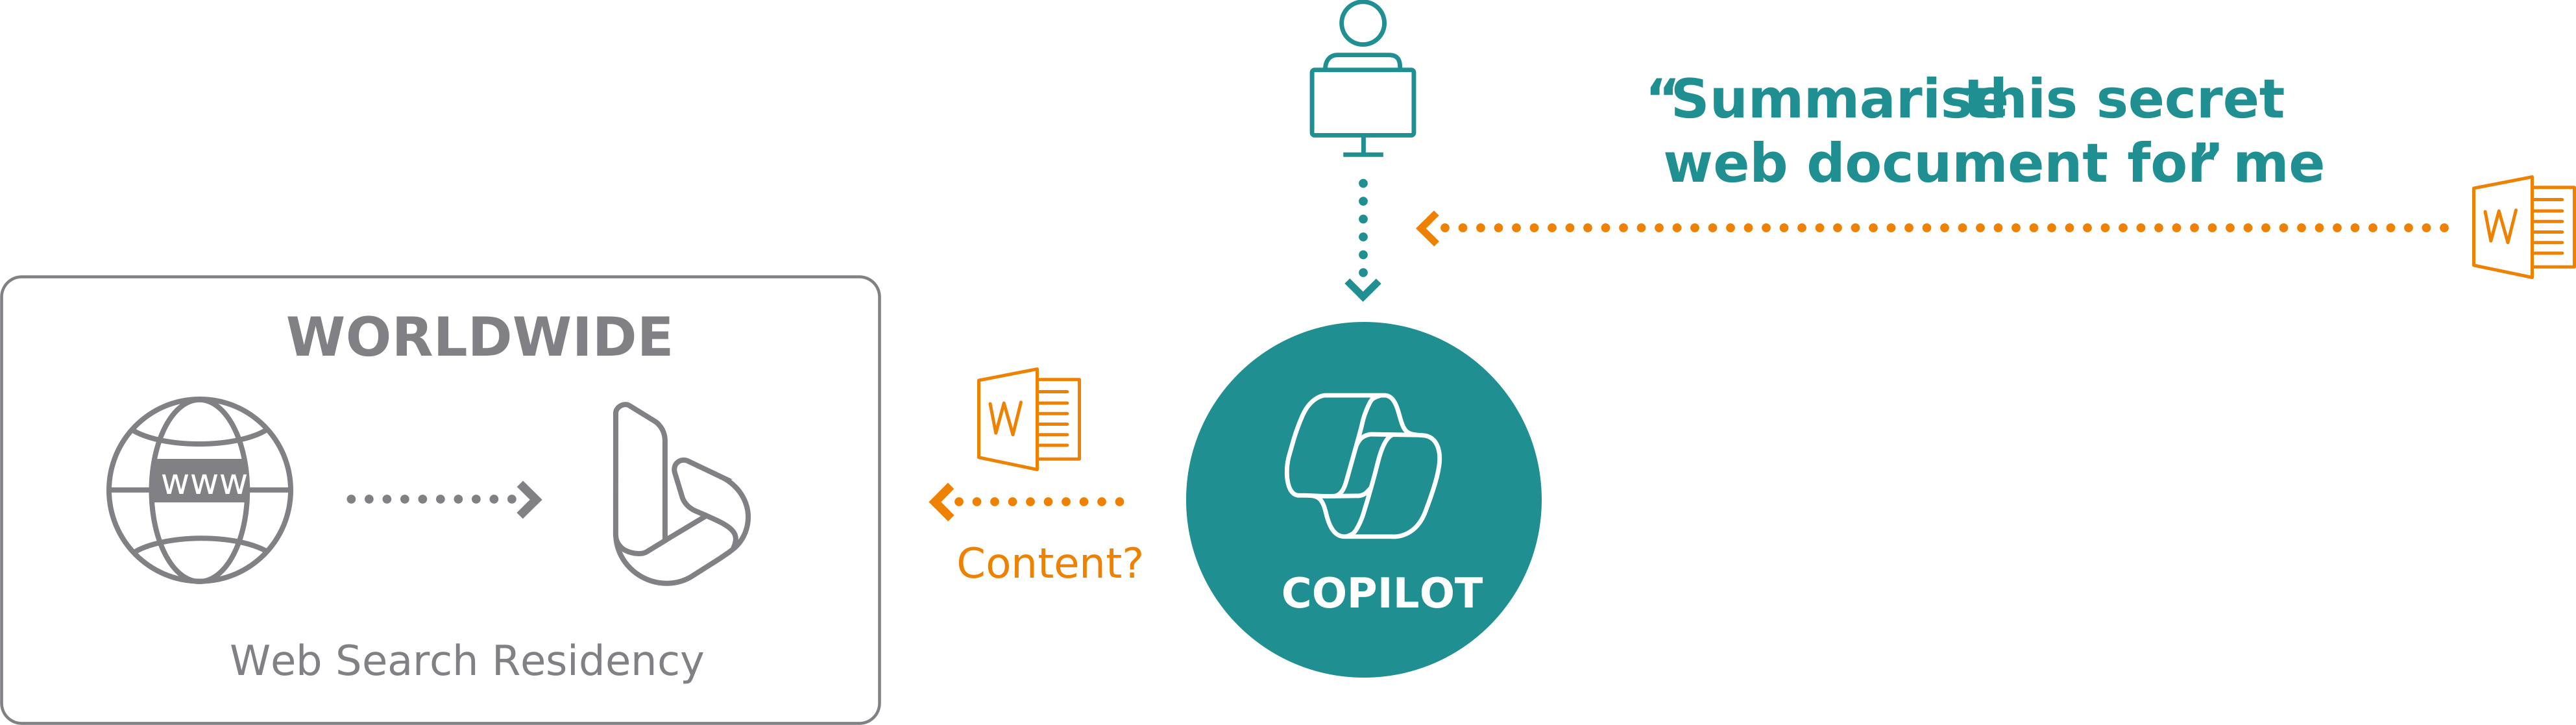
C’è un aspetto che spesso viene trascurato quando si utilizza l’IA: la ricerca sul web, ovvero il “web grounding”.
Molti assistenti IA sono in grado di integrare nelle loro risposte informazioni aggiornate provenienti da Internet. In questo contesto, alcune parti di una richiesta possono essere inoltrate a un motore di ricerca. A questa fase di elaborazione si applicano, a seconda del fornitore, condizioni contrattuali o ubicazioni dei dati diverse rispetto a quelle del servizio IA vero e proprio.
Nel caso di Microsoft 365 Copilot, ad esempio, VISCHER sottolinea che, quando si utilizza Bing Search per questa fase di elaborazione, non si applica il DPA di Microsoft.
Ciò diventa particolarmente rilevante quando la stessa richiesta di ricerca contiene già informazioni riservate. Il nome di un cliente, i dati di un contratto o i dettagli di un progetto interno possono far parte di una richiesta di questo tipo.
La configurazione concreta varia a seconda del fornitore e del prodotto. MTF raccomanda pertanto di non attivare di default la ricerca web e il grounding negli ambienti aziendali. Dovrebbero essere utilizzati in modo mirato laddove sono necessari per il caso d’uso specifico e dove i flussi di dati associati sono stati chiariti.
Le differenze stanno nei dettagli
Oltre alla ricerca sul web, entrano in gioco anche altri fattori: l’ubicazione dei dati, l’utilizzo dei dati inseriti per l’addestramento, il monitoraggio degli abusi, i periodi di conservazione, la politica di “zero data retention” e le garanzie contrattuali.
Un confronto semplificato basato sull’analisi MTF evidenzia alcune delle differenze:
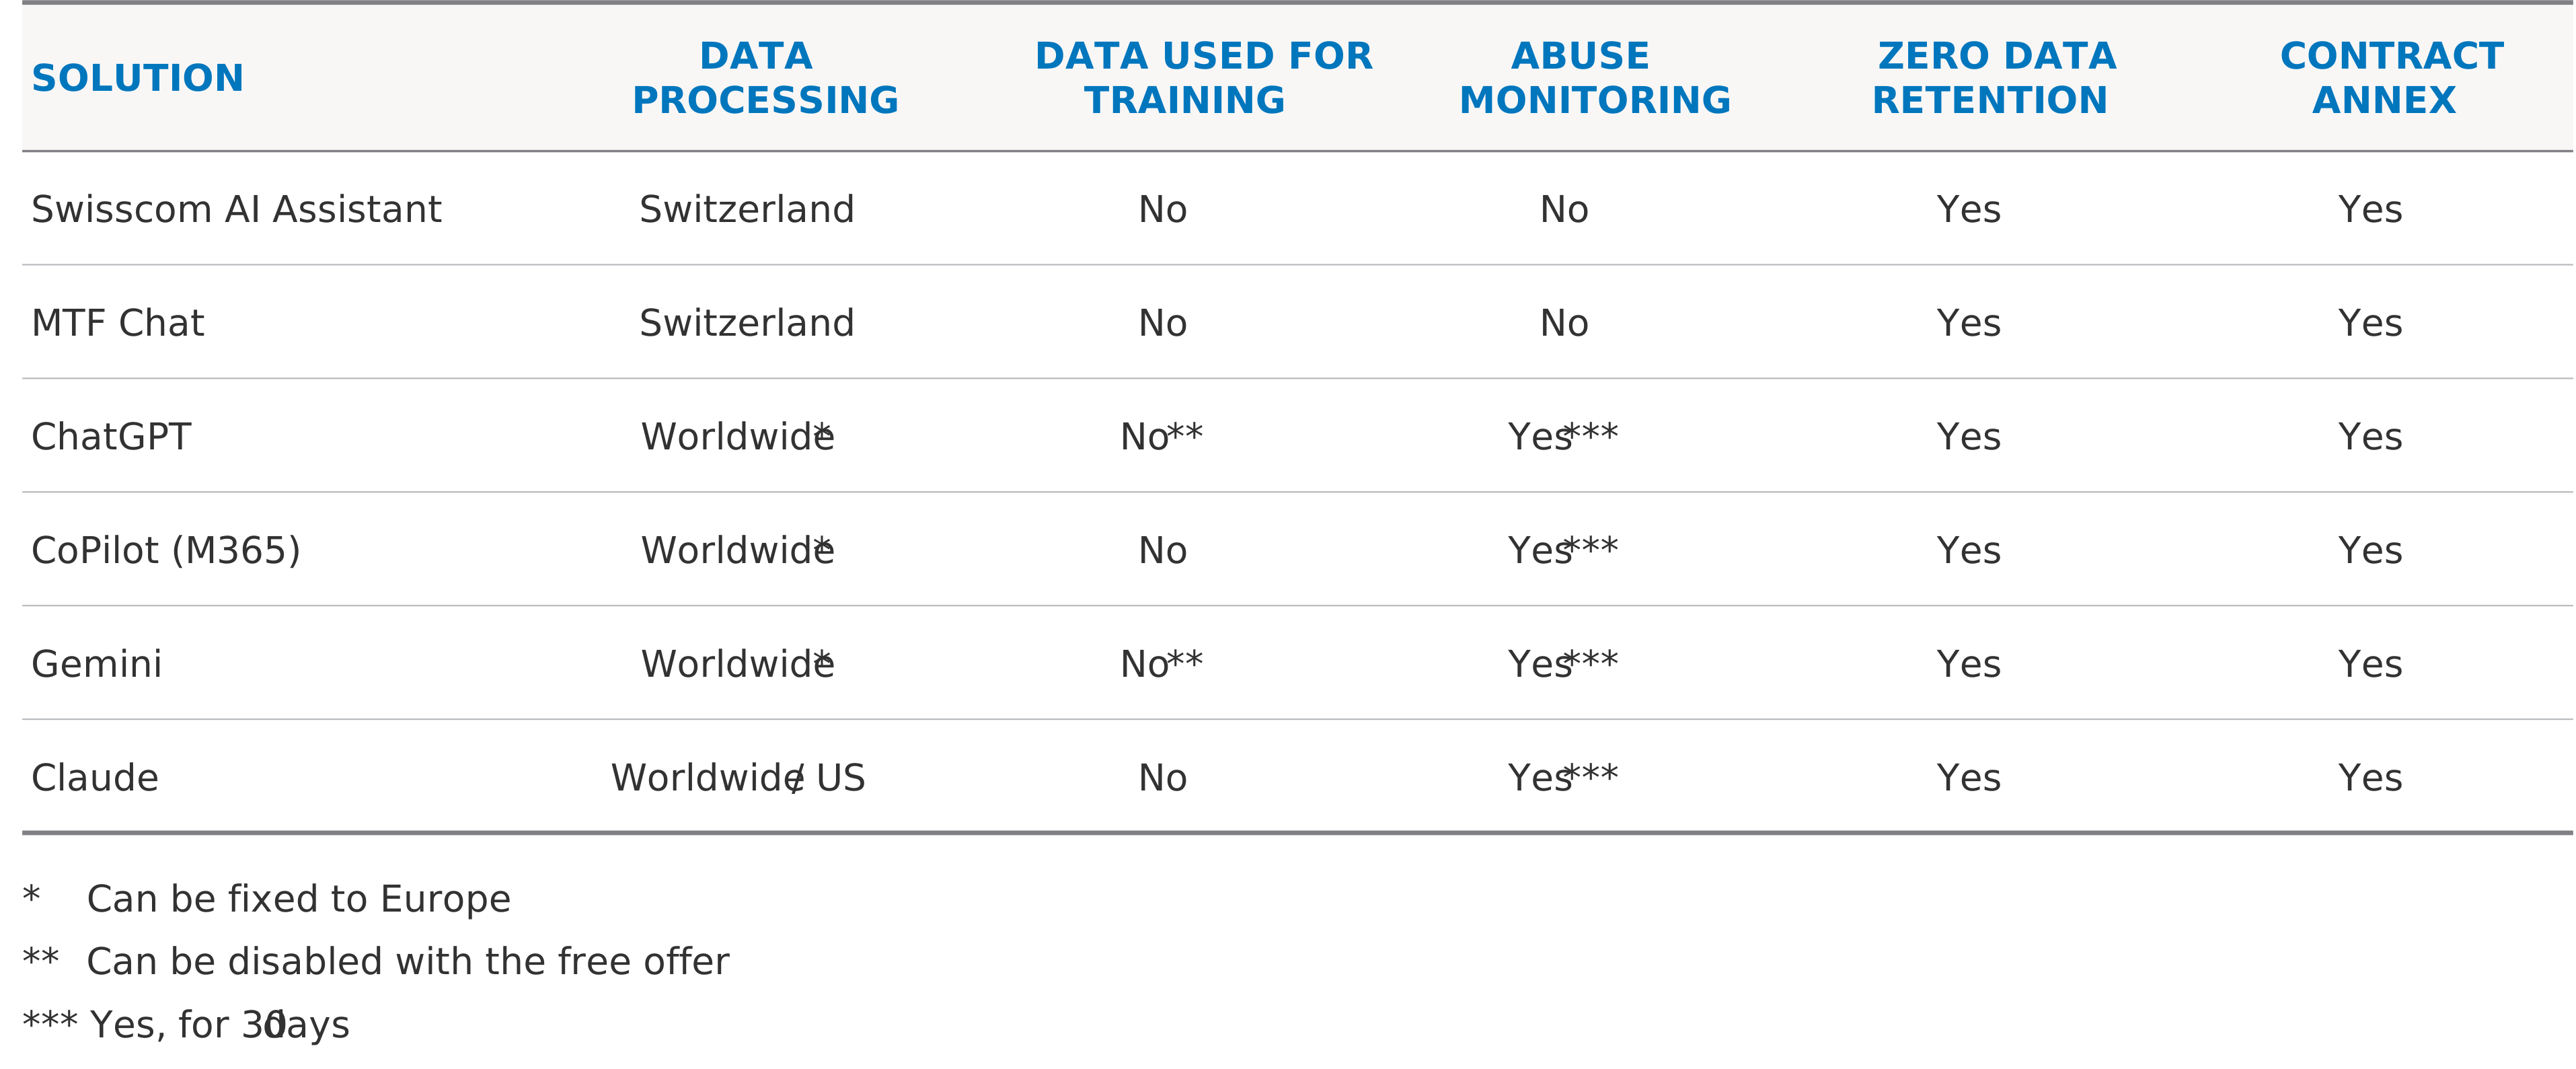
Classificazione semplificata basata sull’analisi MTF delle soluzioni di intelligenza artificiale più diffuse. Le varianti di prodotto, le funzioni e le condizioni contrattuali variano e possono subire modifiche. Fanno quindi sempre fede le condizioni del servizio concretamente utilizzato.
In diverse offerte internazionali, i contenuti possono essere conservati per un periodo limitato ai fini del rilevamento di abusi. Soprattutto nel caso di informazioni riservate, nonché di segreti professionali e d’ufficio, è quindi necessario verificare se tale trattamento sia compatibile con i requisiti di riservatezza richiesti.
Oltre alla sede di conservazione dei dati, è rilevante anche quali sub-responsabili del trattamento siano coinvolti e a quali ordinamenti giuridici siano soggetti il fornitore e il trattamento dei dati. Nel caso di offerte Business ed Enterprise, pertanto, oltre al contratto e alla configurazione, è necessaria anche una valutazione dei rischi documentata per decidere se un servizio sia idoneo al caso d’uso previsto.
Cosa è cambiato nel 2026 per i fornitori svizzeri di IA
L'attuale panoramica VISCHER del luglio 2026 include per la prima volta anche fornitori svizzeri di IA. Tra questi figura MTF Solutions AG.
VISCHER ritiene che, a determinate condizioni, sia in linea di principio possibile l’utilizzo di questa soluzione per dati riservati e dati personali. Anche per quanto riguarda il segreto professionale e d’ufficio, MTF è indicata come fornitore, a condizione che venga applicato il relativo allegato contrattuale.
Questo non costituisce un marchio di qualità e non sostituisce la verifica del caso d’uso concreto. Per le aziende, tuttavia, questa classificazione indipendente offre un ulteriore orientamento nella scelta di soluzioni di IA adeguate.
Nel caso di MTF Private AI, l’attenzione non è incentrata su un singolo modello linguistico, bensì sul modello operativo. I servizi di IA vengono eseguiti nel MTF Private Cloud, mentre l’inferencing e l’elaborazione dei dati avvengono in Svizzera. I dati dei clienti non vengono utilizzati per l’addestramento dei modelli. A ciò si aggiungono la Zero Data Retention e un funzionamento senza monitoraggio degli abusi.
Proprio nel caso di informazioni soggette al segreto professionale o d’ufficio, vigono requisiti più rigorosi. Ciò riguarda, ad esempio, fiduciari, studi legali, autorità, organizzazioni sanitarie o altre istituzioni pubbliche. In questo caso, la sola ubicazione dei dati non è sufficiente. È determinante anche la tutela contrattuale. A tal fine, MTF mette a disposizione un apposito allegato contrattuale.
Una semplice classificazione dei dati garantisce chiarezza
Un divieto generalizzato dell’IA raramente risolve il problema. Se ai collaboratori non vengono forniti strumenti adeguati, aumenta il rischio che vengano utilizzati servizi liberamente disponibili al di fuori delle linee guida aziendali. Una governance efficace dell’IA inizia quindi con una risposta chiara alla domanda: quali dati possono essere trattati con quali servizi?
Una semplice classificazione può già fare la differenza:
- Informazioni pubbliche
Possono essere trattate in servizi di IA pubblici autorizzati a tale scopo. - Informazioni interne
Devono essere trattate esclusivamente con soluzioni Business o Enterprise verificate e autorizzate. - Informazioni riservate o particolarmente sensibili
Richiedono adeguate misure di protezione tecniche e contrattuali. - Segreti professionali e d’ufficio
Richiedono una valutazione specifica e un’adeguata tutela contrattuale.
Da ciò è possibile ricavare linee guida concrete sull’utilizzo per i collaboratori. Anziché lunghi elenchi di divieti, si ottiene un semplice orientamento per la quotidianità lavorativa.
Conclusione: Sono i dati a decidere
L’IA pubblica e quella privata rispondono a esigenze diverse. Per molte attività quotidiane, i servizi business ed enterprise offerti dal cloud pubblico possono rappresentare la scelta giusta. Quanto più riservate sono le informazioni e quanto più elevati sono i requisiti in materia di sovranità dei dati e riservatezza, tanto più importanti diventano l’elaborazione dei dati, il modello operativo e le garanzie contrattuali.
Le aziende non devono quindi bloccare il maggior numero possibile di servizi di IA. Dovrebbero piuttosto sapere quali strumenti vengono utilizzati, quali dati vengono trattati e quale servizio è autorizzato per quale caso d’uso.
Un prompt non avrà bisogno di alcuna autorizzazione nemmeno in futuro. Ma se è chiaro quali dati possono essere trasferiti e dove, non ne avrà bisogno.
MTF: il vostro partner per un utilizzo sicuro dell'IA
MTF supporta le PMI svizzere nell’integrazione controllata dell’IA nella routine lavorativa. Ciò comprende la classificazione dei dati e dei casi d’uso, la definizione di linee guida d’utilizzo comprensibili, nonché la selezione e l’implementazione tecnica di soluzioni di IA pubbliche e private adeguate.
Si crea così un ambiente di IA che favorisce la produttività e, al contempo, soddisfa i requisiti aziendali in materia di protezione dei dati, riservatezza e sovranità dei dati.
FAQ
- I dipendenti possono utilizzare ChatGPT, Copilot o Gemini con i dati aziendali?
Dipende dai dati trattati, nonché dalla variante del prodotto, dal contratto e dalla configurazione. Le offerte consumer disponibili gratuitamente sono spesso inadatte ai dati aziendali sensibili. Le offerte Business ed Enterprise possono essere utilizzate a determinate condizioni.
- Una versione a pagamento dell’IA è automaticamente conforme alle norme sulla protezione dei dati?
No. Una licenza «Business» o «Enterprise» può offrire condizioni contrattuali migliori, ma non sostituisce la verifica dell’utilizzo concreto. Sono determinanti, tra l’altro, l’accordo sul trattamento dei dati (DPA), il trattamento dei dati, i periodi di conservazione e la configurazione.
- Perché la ricerca sul web negli strumenti di IA costituisce una questione di conformità a sé stante?
Perché durante una ricerca sul web possono essere coinvolti nel trattamento servizi aggiuntivi. Di conseguenza, alcune parti di un prompt possono essere soggette a condizioni contrattuali e flussi di dati diversi rispetto all’applicazione di IA vera e propria.
- Cosa significa «zero data retention»?
«Zero data retention» significa che i contenuti di una richiesta non vengono conservati dal fornitore oltre il periodo necessario per l’elaborazione immediata. Le specifiche tecniche e contrattuali concrete devono essere verificate in relazione al servizio in questione.
- Cosa vale per i segreti professionali e d’ufficio?
In questo caso si applicano requisiti più rigorosi in materia di riservatezza e protezione dell’accesso. Oltre alle misure tecniche, sono necessarie adeguate disposizioni contrattuali. Un normale contratto di elaborazione dei dati non è sufficiente in tutti i casi.
- Cosa distingue la Public AI dalla Private AI?
La Public AI viene fornita tramite l’infrastruttura di un fornitore di piattaforma esterno. Nel caso della Private AI, l’ambiente operativo può essere adattato in modo mirato a requisiti quali l’ubicazione dei dati, l’archiviazione e la riservatezza. La scelta della variante più adatta dipende dal caso d’uso specifico e dai dati trattati.
- Che cos’è l’Abuse Monitoring?
Nel monitoraggio degli abusi, un fornitore verifica le richieste o i risultati alla ricerca di possibili violazioni delle proprie linee guida di utilizzo e sicurezza. A seconda del servizio, i contenuti possono essere archiviati o analizzati per un periodo di tempo limitato. Per i dati particolarmente riservati, è quindi opportuno verificare questo aspetto prima dell’utilizzo.
- In che modo MTF supporta le aziende nella governance dell’IA?
MTF affianca le aziende nella classificazione dei dati e dei casi d’uso, nella definizione delle linee guida di utilizzo, fino alla selezione e all’implementazione di soluzioni di IA pubbliche e private adeguate.
Anche interessante
Avete Domande?
Tobias Menzi
Geschäftsleiter Region Liechtenstein, St. Gallen & Chur